Haru 4B
我々人類はAIに何を望み、何を夢見たのでしょうか。その中心には、いつも「人間らしいAI」の存在があったように思います。多くのSF映画や漫画は、AIが私たちと同じように話し、感情を分かち合い、互いに支え合う未来を描いてきました。
人間らしい会話は、言葉だけでできているわけではありません。相手の話に思わず笑い、言葉を重ね、ときには沈黙を分かち合う。そうした瞬間の積み重ねが、私たちの心を通わせます。しかし、この実現の基盤となるfull-duplex技術は、これまで十分に取り組まれてきませんでした。
この技術をより多くの人とともに発展させるため、私たちはこのfull-duplexモデル Haru 4Bをオープンソースとして公開します。Haru 4Bは、事前学習済みの4Bパラメータのベースモデルです。今後はさらに大規模なモデルの開発にも取り組みながら、世界中の研究者や開発者とともに、人間らしいAIと語り合う未来を、私たちの日常にしていきたいと考えています。
1. What is Haru 4B? — Modern Full duplex S2S model
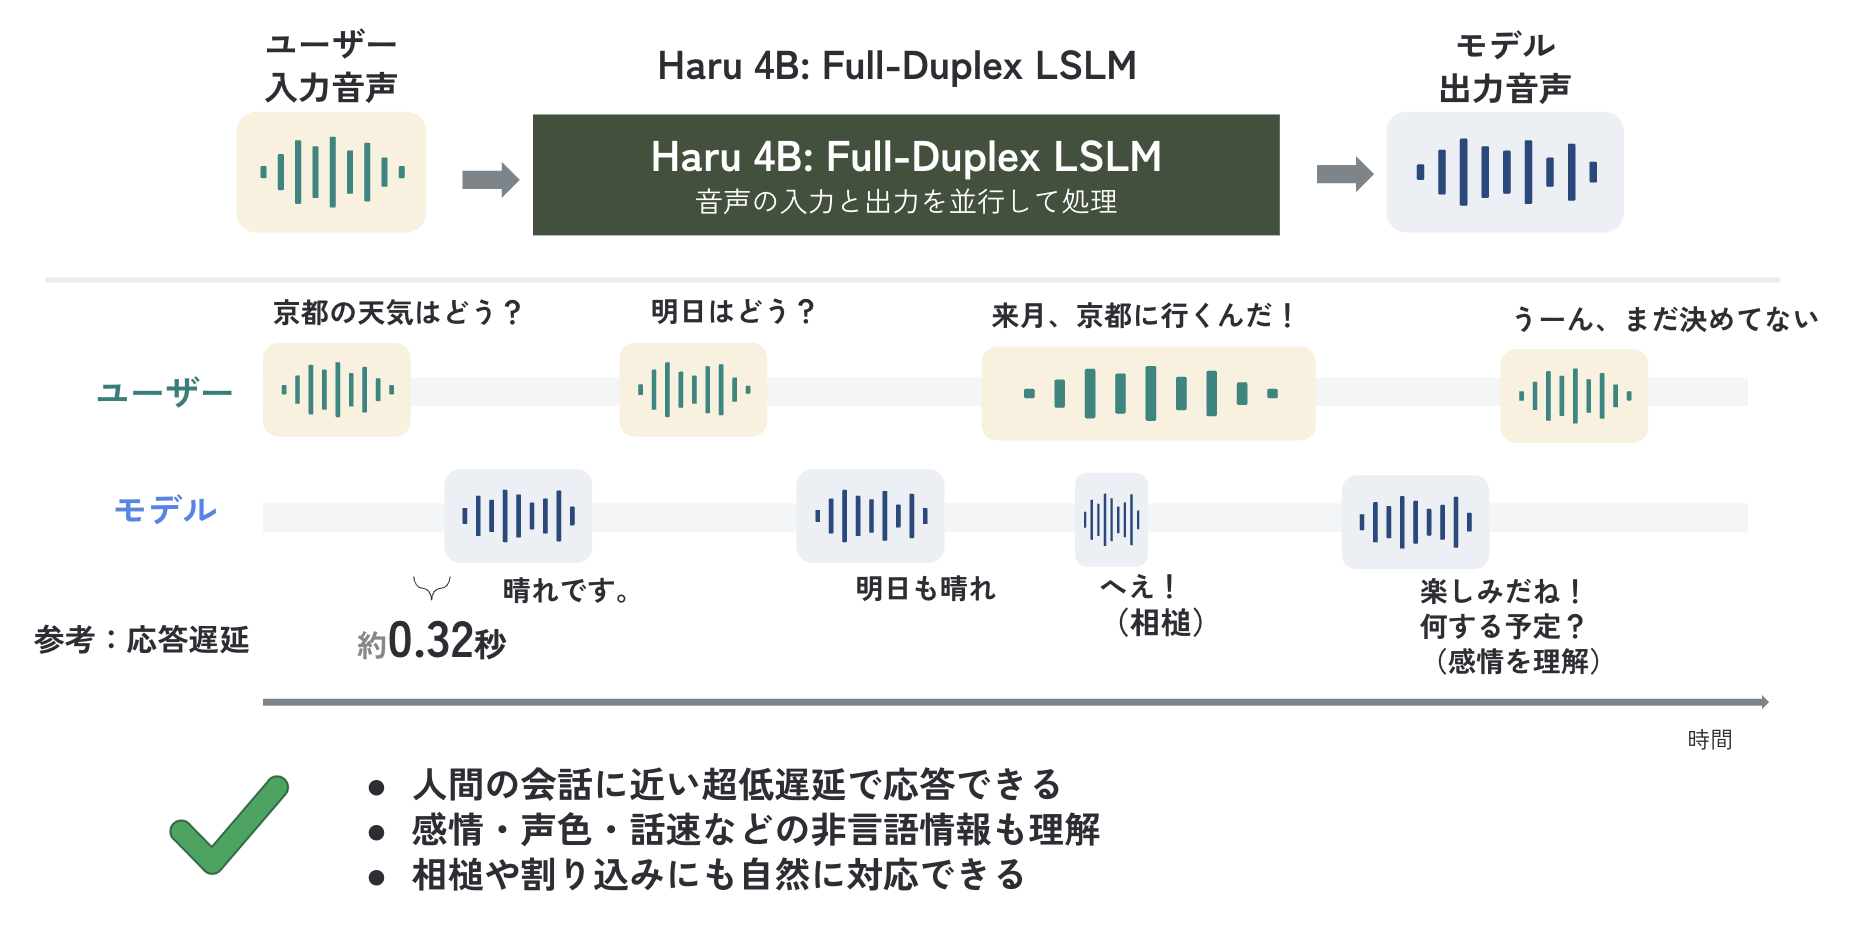
Haru 4Bは、聞きながら話せるEnd-to-Endの全二重音声対話モデルです。
音声認識・LLM・音声合成を順に行うカスケード型には、処理の遅延に加え、文字起こしに表れない抑揚・感情・話者の特徴などのパラ言語・非言語情報を十分に活かせないという課題があります。Haru 4Bは音声を直接扱い、「何を答えるか」だけでなく、相づちや割り込みを含めて「いつ、どう応じるか」も学ぶことで、自然な音声対話を実現します。
図1|カスケード型のメカニズムと課題点
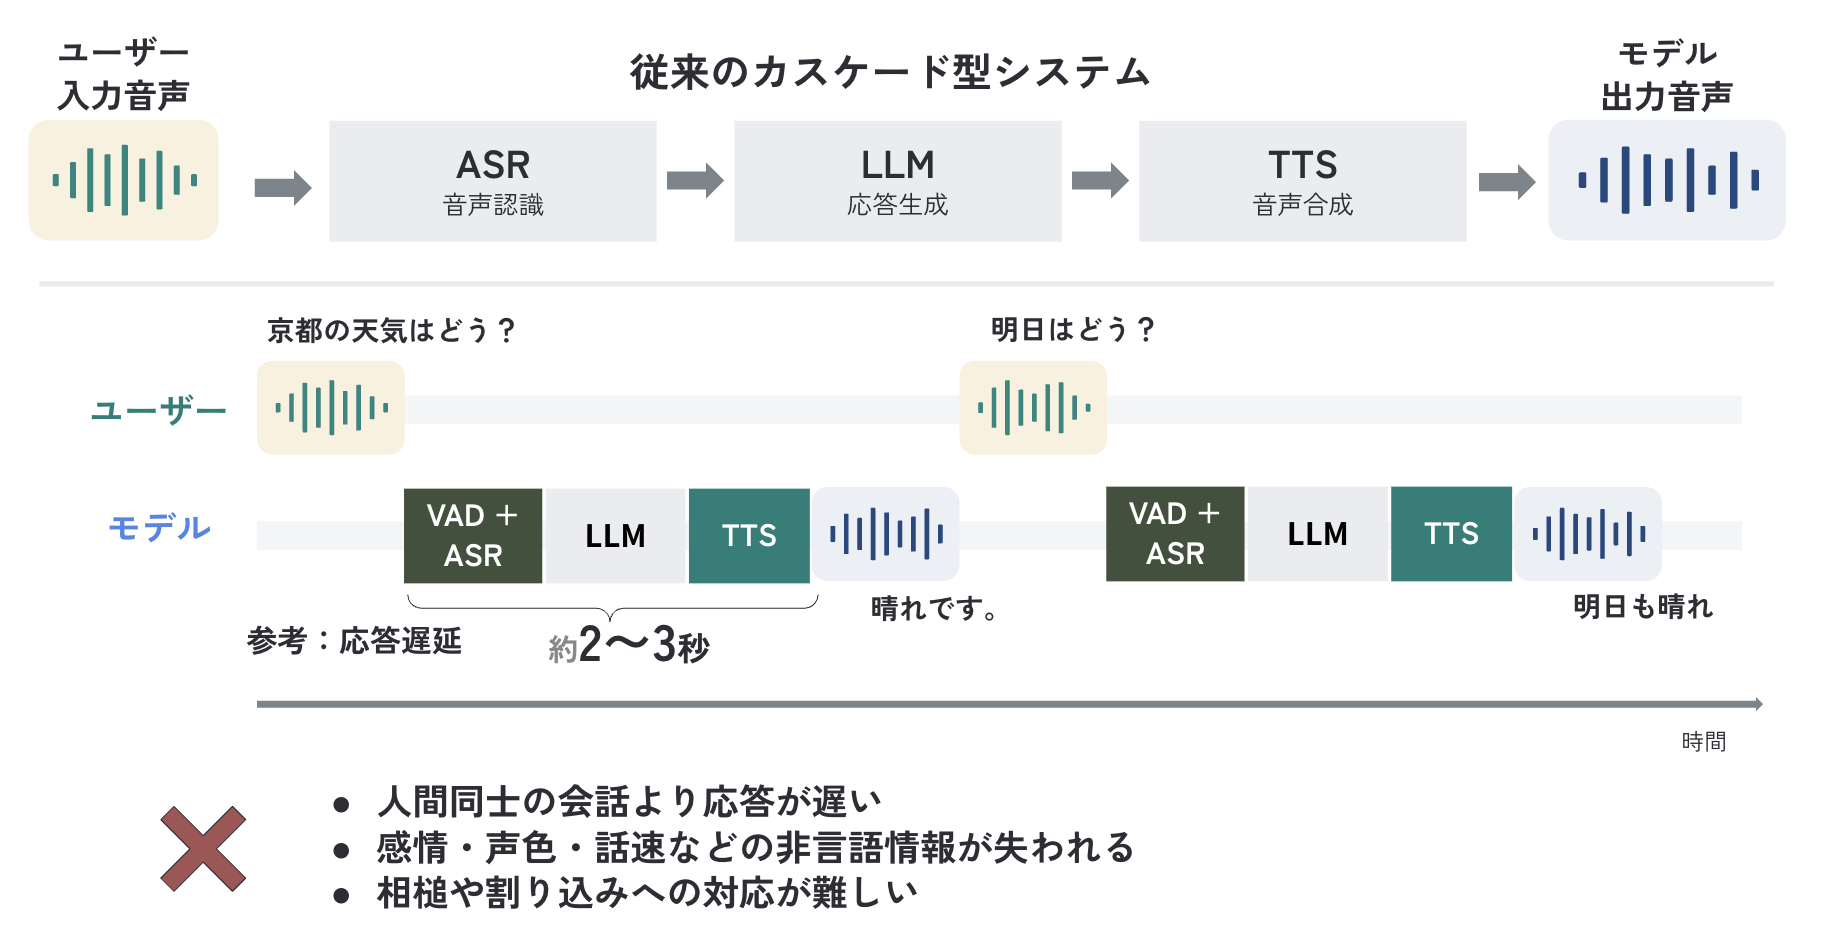
図2|Haru 4B: Full duplex LSLM modelのメカニズムと強み
2. Listen to Haru — 4つの会話デモ
Haruの特徴は、説明するより会話を聞くほうが伝わります。自然な発声・レイテンシーの少ない会話の移り変わり・相槌/割り込みをご覧ください
Demo 01 - 経済についての雑談 (JP)
大学の同級生との雑談: 人間らしい話者の移り変わりとレスポンス
待ち合わせをしていた大学の同級生との経済に関する雑談。Haruは相手の発話内容に合わせて、相槌を入れ、自然な受け答えをし、発話内容の感情表現や話速を文脈に合わせて自動で調整します。
Demo 02 - 映画に関する雑談 (EN)
映画に関する雑談: 笑うなどの感情豊かさと、相槌と発話が重なりながら続く固有名詞を理解した会話
好きな恋愛映画についての雑談。ユーザーの相槌が発話に重なる場面でも話を続け、好きな映画について話題を広げています。
Demo 03 - 子育てに関する雑談 (JP)
子育てに関する雑談: 冗談に笑うなどの感情豊かさと、オーバーラップの多い会話
子育て方法に関する雑談。話題に合わせた共感や、結論部分に対する強調、ユーザーの冗談に対して笑うなどの人間らしい自然な応答を実現しています
Demo 04 - 投資に関する相談 (EN)
投資に関する相談: ロールに基づく、シリアスな会話トーンの移り変わり
投資に関するファイナンシャルアドバイザーとの会話。
最初はフランクな口調で会話を始め、話題が真剣な相談へと移るにつれて、自然に落ち着いたプロフェッショナルなトーンへと変化します。
こちらの電話番号から、Haru 4Bと話すことができます。是非「自己紹介をお願いします」から始めて色々質問してみてください。
(あくまで4Bと限定的なモデルサイズであり、GPT2程度の知性を期待してお話し頂ければと思います。電話番号は予告なく、停止することがあります。)
- 050-5444-3154(日本語: 男性)
- 050-5444-3155(日本語: 女性)
3. Architecture
複数ストリームをリアルタイム処理した構成
Haruは、ユーザー音声・モデル音声・テキストの3つのストリームを、同じ時間軸上で同期して処理します。約133ms(7.5Hz)ごとに3つのストリームの情報を統合し、単一の言語モデルで処理することで、ユーザーの声を聞き続けながら、音声とテキストをリアルタイムに生成します。
従来のように音声とテキストを交互に処理する方式と異なり、3つのストリームでトークン位置を共有するため、系列長を抑えながら、相槌・割り込み・発話の重なりを含む自然な会話を学習できます。
連続トークンを採用
Haru 4Bでは、VibeVoice(ICLR 2026)の連続音声トークナイザーを採用しました。音声を1秒あたり7.5個の連続特徴量で表現し、高い音質を保ちながら系列長を短くすることで、学習・推論の計算負荷を抑えます。
詳細については、こちらのTech blogを確認ください。
4. Open Weights, Open Research
私たちは、人間らしいAIの実現のためにはオープンな研究コミュニティの力が重要だと考えています。
Haru 4Bでは、モデル重みをHugging Faceで公開し、推論コードをGitHubで公開します。本Haru 4Bは、事前学習後のベースモデルです。皆さんと共にこの分野のフロンティアを切り開くことを望みます。
- Model Weights - Hugging Face:
- https://huggingface.co/higurashi-ai/Haru-4B
- Inference Code - GitHub:
- https://github.com/higurashi-ai/Haru
5. Join us / Get in touch
弊社の4Bモデルを含め、現在公開されている多くのFull-duplexモデルと、私たちが思い描く「人間らしいAI」との間には、未だ大きな隔たりがあると考えています。
higurashiは、Full-duplexモデルを言語モデルと同じようにスケーリングさせ、「人間らしいAI」を完成させることを目指しています。この挑戦をともに進める研究者・エンジニアを募集しています。音声モデル、大規模学習、データ処理、推論高速化、評価などの領域で、一緒に研究開発に取り組みたい方のご応募をお待ちしています。
また、4Bモデルの公開に合わせてMeetupを11/26 (木)に本郷三丁目周辺で開催予定です。私たちの取り組みに関心のある方は、ぜひご参加ください。
Let's talk.
共同研究、モデル活用、API・プロダクト連携などに関心のある方は、こちらからご連絡ください。
contact@higurashi.ai